Enc. 2: Correlação de Pearson
Relação linear entre variáveis contínuas · coeficiente r
📊 Slides
🍊 Metáfora
Imagine isso…
Dois atletas correm lado a lado numa pista. Quando um acelera, o outro acelera na mesma proporção; quando freia, o outro freia também. Isso é r = +1: movimento em perfeita sincronia, na mesma direção. Se um acelera enquanto o outro freia (na mesma medida), temos r = −1. Se cada um corre no seu ritmo, sem seguir o outro, r ≈ 0.
Pearson quantifica essa sincronia, mas só enquanto a pista for reta.
E se a pista não for reta? Imagine que os dois atletas correm num trecho plano, lado a lado, em perfeita sincronia. De repente, a pista encontra uma colina. Na subida, um deles tem mais força e mantém o ritmo; o outro cansa e desacelera, e a sincronia que existia no plano se desfaz. O padrão muda de comportamento ao longo do percurso (uma reta, depois uma subida): não existe uma única reta que descreva bem todo o trajeto. Dependendo do tamanho da subida em relação ao trecho plano, r pode cair bastante, chegando perto de 0 mesmo havendo um padrão bem claro no gráfico.
🎯 Para que serve
Mede a força e a direção de uma relação linear entre duas variáveis numéricas contínuas. O coeficiente r vai de −1 a +1.
O que é relação linear? Ao plotar X × Y, os pontos tendem a se alinhar numa linha reta: cada aumento de X produz, em média, um acréscimo (ou decréscimo) constante em Y, como em Y = a + bX.
Por quê Pearson exige isso? O r mede o quanto esses pontos se aproximam de uma reta. Em relações curvilíneas, trechos em que Y sobe e trechos em que Y desce se cancelam, e r pode ficar perto de zero mesmo quando o padrão é visível no gráfico. Por isso confira sempre o scatter plot antes de calcular.
Scatter plot (gráfico de dispersão): cada par de valores (X, Y) vira um ponto no plano. Antes de calcular Pearson, plote sempre as duas variáveis juntas: a nuvem de pontos mostra se a relação é linear, curvilínea ou inexistente, o que o número r sozinho não revela.
Em termos de hipótese:
| H₀ | Não há relação linear entre as variáveis (r = 0 na população). |
| H₁ | Existe relação linear (r ≠ 0). |
Em dados conversacionais, um exemplo típico cruza duas fontes por estudante: o número de mensagens trocadas no chat, extraído dos logs de um chatbot baseado em LLM, e o escore composto numa escala de metacognição (ex.: Metacognitive Awareness Inventory, ou MAI), aplicada separadamente como questionário. A pergunta é: quanto mais mensagens um estudante troca com o chatbot, maior o seu escore no MAI? Pearson responde se os pontos tendem a subir numa linha reta, não se um causa o outro.
Por que usar o escore composto, e não um item isolado do MAI? O MAI é respondido em itens de escala Likert, que são ordinais. Mas a soma (ou média) de muitos itens ordinais se aproxima de uma distribuição contínua, por isso é aceitável tratá-la como quase-contínua e usar Pearson nesse nível, diferente de correlacionar diretamente com um único item Likert.
🧮 Fórmula
O r de Pearson compara, estudante a estudante, o quanto X e Y se afastam das suas próprias médias, como os dois atletas da metáfora inicial, cada um correndo ao redor da própria média. Quando os dois se afastam na mesma direção (ambos acima da média, ou ambos abaixo), o numerador cresce e r fica positivo; quando se afastam em direções opostas, o numerador diminui e r fica negativo.
| r = | Σ (xᵢ − x̄)(yᵢ − ȳ) |
| √[ Σ(xᵢ − x̄)² × Σ(yᵢ − ȳ)² ] |
Lendo a fórmula: xᵢ e yᵢ são os valores de X e Y de cada estudante; x̄ e ȳ são as médias de X e de Y; Σ soma o resultado para todos os estudantes; √ é a raiz quadrada. O numerador soma o produto dos desvios de cada par, o quanto X e Y “andam juntos”; o denominador usa a dispersão de cada variável para normalizar esse valor, o que garante que r fique sempre entre −1 e +1.
Como r é calculado, passo a passo:
- Calcule as médias, x̄ e ȳ.
- Para cada estudante, calcule os desvios: xᵢ − x̄ e yᵢ − ȳ.
- Multiplique os dois desvios de cada estudante e some todos os resultados → numerador.
- Eleve cada desvio ao quadrado, some cada coluna separadamente, multiplique os dois totais e tire a raiz quadrada → denominador.
- Divida o numerador pelo denominador → r.
Aplicação simples: aplicando os passos a 5 estudantes
Para ver os passos acima em ação, seguem 5 estudantes fictícios com o número de mensagens trocadas com o chatbot (X) e o escore composto no MAI (Y), o mesmo par de variáveis usado no exemplo Python mais abaixo:
| Estudante | xᵢ (mensagens) | yᵢ (escore no MAI) | xᵢ − x̄ | yᵢ − ȳ | (xᵢ−x̄)(yᵢ−ȳ) | (xᵢ−x̄)² | (yᵢ−ȳ)² |
|---|---|---|---|---|---|---|---|
| A | 2 | 40 | −4 | −20 | 80 | 16 | 400 |
| B | 4 | 50 | −2 | −10 | 20 | 4 | 100 |
| C | 6 | 70 | 0 | 10 | 0 | 0 | 100 |
| D | 8 | 60 | 2 | 0 | 0 | 4 | 0 |
| E | 10 | 80 | 4 | 20 | 80 | 16 | 400 |
| Soma | x̄ = 6 | ȳ = 60 | 0 | 0 | 180 | 40 | 1000 |
- Médias (passo 1): x̄ = (2+4+6+8+10) / 5 = 6 · ȳ = (40+50+70+60+80) / 5 = 60.
- Numerador (passos 2–3): soma da coluna (xᵢ−x̄)(yᵢ−ȳ) = 80+20+0+0+80 = 180.
- Denominador (passo 4): √(40 × 1000) = √40000 = 200.
- Resultado (passo 5): r = 180 / 200 = 0,90.
Interpretação: r = 0,90 é uma correlação positiva forte (Cohen: |r| ≥ 0,50 → efeito grande). Nesses 5 estudantes fictícios, quem trocou mais mensagens com o chatbot tendeu claramente a ter maior escore no MAI. No exemplo Python mais abaixo,
scipy.stats.pearsonrfaz exatamente essa conta, só que para os 10 estudantes do conjunto de dados completo.
🔢 O que significa r?
| Valor de r | Direção | Interpretação intuitiva |
|---|---|---|
| +1 | positiva | Quanto mais X, mais Y, em linha reta perfeita. |
| 0 | nenhuma | X e Y variam de forma independente (linearmente). |
| −1 | negativa | Quanto mais X, menos Y, em linha reta perfeita. |
| entre 0 e ±1 | parcial | Há tendência, mas com dispersão em torno da reta. |
O sinal (+ ou −) indica a direção; o valor absoluto |r| indica a força da relação linear.
Convenção de Cohen (1988) para o tamanho do efeito: |r| < 0,10 negligível · 0,10 a 0,29 pequeno · 0,30 a 0,49 médio · ≥ 0,50 grande
📋 Quando usar
Use Pearson quando:
- ✅ Ambas as variáveis são contínuas e numéricas (mensagens, escores compostos, tempo em segundos).
- ✅ A relação esperada é linear: os pontos, ao serem plotados, tendem a formar uma reta (não uma curva). Confira sempre com um scatter plot antes de calcular.
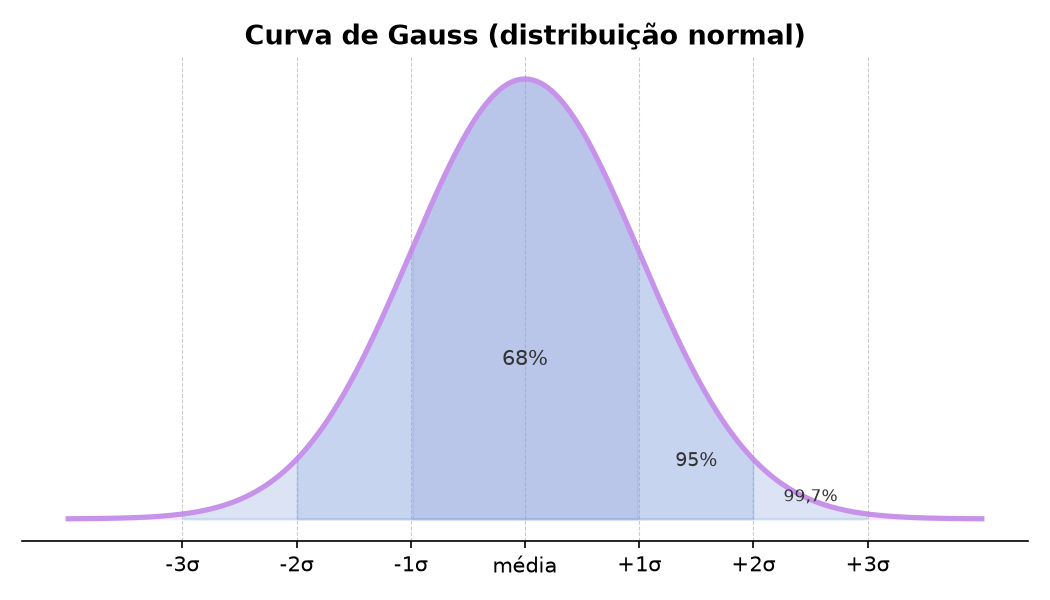
- ✅ Cada variável, isoladamente, deve seguir uma distribuição aproximadamente normal (teste de Shapiro-Wilk, explicado em detalhe mais abaixo): a maioria dos estudantes fica perto de um valor “médio”, e cada vez menos estudantes aparecem conforme os valores se afastam dessa média.
O que é uma distribuição normal? É o formato de sino da curva abaixo: simétrica em torno da média, com a maior concentração de estudantes perto do centro e cada vez menos estudantes conforme os valores se afastam da média, para os dois lados. Aproximadamente 68% dos dados ficam a até 1 desvio padrão da média, 95% a até 2 desvios padrão, e 99,7% a até 3 desvios padrão.
Exemplos em logs educacionais (learning analytics):
- Número de mensagens × escore composto no MAI: estudantes que trocam mais mensagens com o chatbot têm maior consciência metacognitiva?
- Tempo ativo no chatbot × nota na avaliação: quem permanece mais tempo na plataforma obtém notas mais altas?
- Número de mensagens × acertos em exercícios: mais mensagens trocadas se associam a mais respostas certas?
- Latência média de resposta × tempo total de sessão: respostas mais rápidas acompanham sessões mais longas?
- Sessões concluídas por semana × desempenho acumulado: frequência de uso se correlaciona com progresso ao longo do curso?
Evite Pearson quando:
- ❌ Os dados são ordinais, como um item isolado de escala Likert (1 a 5) → use Spearman.
- ❌ Há outliers extremos: um único ponto pode distorcer r.
- ❌ A nuvem de pontos é claramente curvilínea → Pearson não captura bem o padrão.
- ❌ Você quer afirmar causalidade: correlação só descreve associação.
Por que evitar Pearson com um item Likert isolado? Os números de 1 a 5 indicam apenas ordem (5 é mais concordância que 4), não uma régua com espaçamento igual entre eles. Pearson, porém, calcula a distância matemática entre os números como se 5 − 4 valesse exatamente o mesmo que 2 − 1. Na prática, para uma pessoa, sair de “discordo” (2) para “neutro” (3) pode ser um salto de opinião muito maior do que sair de “concordo” (4) para “concordo totalmente” (5), mas Pearson trataria os dois saltos como idênticos. Spearman compara apenas o ranking das respostas, por isso não sofre com esse problema.
Quando evitar em logs educacionais (learning analytics):
- Satisfação com o chatbot (Likert 1 a 5) × número de sessões: variável ordinal → use Spearman.
- Turnos por sessão × escore com ponto ideal no meio: sessões com poucos turnos (desengajamento, abandono rápido) e sessões com muitos turnos (confusão, divagação ou dificuldade excessiva) podem ter escores baixos; o melhor desempenho costuma ficar em um intervalo intermediário. No scatter plot, a nuvem forma uma curva (∩), não uma reta. Pearson pode retornar r ≈ 0 mesmo com padrão visível, porque trechos opostos se cancelam.
- Um único estudante com centenas de mensagens × tempo de sessão: outlier extremo pode inflar ou distorcer r.
- Uso do chatbot × nota final para inferir causalidade: mais tempo na plataforma não prova que o chatbot produziu o aprendizado.
- Tempo de sessão com distribuição fortemente assimétrica (cauda longa): normalidade comprometida → considere Spearman ou transformação dos dados.
🔍 Perguntas de pesquisa em Informática na Educação
Em pesquisas de Informática na Educação que analisam conversas de estudantes com chatbots, Pearson serve para responder perguntas em que as duas variáveis são numéricas contínuas e a relação esperada é linear:
- O número de mensagens trocadas com o chatbot está relacionado ao escore composto numa escala de metacognição (ex.: MAI)?
- A extensão média das mensagens do estudante (em caracteres ou tokens) está relacionada à nota final na disciplina?
- O tempo total de sessão com o chatbot está relacionado ao número de exercícios corretos entregues na semana?
- A latência média de resposta do chatbot está relacionada à duração média das sessões do estudante?
- O número de perguntas de esclarecimento feitas ao chatbot está relacionado ao desempenho acumulado ao longo do curso?
Antes de aplicar Pearson a essas perguntas: confirme que ambas as variáveis são realmente contínuas (não faixas categorizadas), plote o scatter plot para verificar linearidade, e teste a normalidade de cada variável com Shapiro-Wilk, explicado na seção seguinte. Se alguma condição falhar, considere Spearman.
🔔 Teste de Shapiro-Wilk
O teste de Shapiro-Wilk verifica, de forma estatística, se uma amostra é compatível com uma distribuição normal, o formato de sino apresentado na seção anterior. É o teste de normalidade mais usado antes de aplicar Pearson.
Em termos de hipótese:
| H₀ | Os dados vêm de uma população com distribuição normal. |
| H₁ | Os dados não vêm de uma população com distribuição normal. |
Como interpretar o resultado, dado por uma estatística W e um valor p:
- p ≥ .05 → não rejeitamos H₀: os dados são compatíveis com a normalidade, Pearson pode ser aplicado.
- p < .05 → rejeitamos H₀: há evidência de que os dados não seguem distribuição normal, considere usar Spearman no lugar de Pearson.
Cuidado com amostras muito grandes. Com muitos estudantes (centenas ou milhares), o teste de Shapiro-Wilk se torna extremamente sensível e pode rejeitar H₀ mesmo diante de desvios pequenos e pouco relevantes na prática. Por isso, nunca decida apenas pelo valor de p: observe também um histograma ou um gráfico QQ-plot dos dados antes de descartar Pearson.
🐍 Exemplo Python: Shapiro-Wilk
Contexto: antes de calcular Pearson entre número de mensagens e escore no MAI, verificar se cada variável, isoladamente, é compatível com a distribuição normal.
Com n = 10 estudantes, é comum que o teste de Shapiro-Wilk não rejeite H₀ (p ≥ .05) para as duas variáveis: nesse caso, o pressuposto de normalidade está atendido, e Pearson é uma escolha adequada.
🪜 Passo a passo na prática
- Visualize: plote X × Y. A nuvem sobe, desce ou é um emaranhado?
- Verifique pressupostos: normalidade univariada (Shapiro Wilk) e ausência de outliers gritantes.
- Calcule:
stats.pearsonr(x, y)oudf.corr(method='pearson'). - Interprete: leia r (direção e força) e p (evidência contra H₀).
- Reporte: informe r, p, n e, se possível, o scatter plot no artigo ou relatório.
📖 Como ler o resultado
Suponha que o código abaixo retorne r = 0.87, p = 0.0003 com n = 10 estudantes:
- r = 0,87 → relação linear forte e positiva: estudantes que trocam mais mensagens tendem a ter escore composto maior no MAI.
- p < .05 → rejeitamos H₀: a associação linear observada é improvável se não houvesse relação na população.
- Cohen → |0,87| ≥ 0,50 → tamanho de efeito grande (embora com n pequeno a estimativa seja instável).
Correlação ≠ causalidade. Mais mensagens podem acompanhar maior consciência metacognitiva, ou estudantes mais metacognitivos simplesmente conversam mais e refletem mais sobre o próprio aprendizado. Outras variáveis (motivação, dificuldade da tarefa) podem explicar ambos.
🐍 Exemplo Python: Pearson
Contexto: verificar se o número de mensagens trocadas com o chatbot se associa ao escore composto no MAI.
O código segue o passo a passo: primeiro o gráfico, depois o cálculo. Execute e compare o scatter plot com o valor de r.
📚 Referências · Biblioteca Digital IFRS
Disponíveis para consulta/e-book em ifrs.pergamum.com.br.
| e-book | Martinez, E. Z. (2023). Bioestatística para os cursos de graduação da área da saúde (2ª ed.). São Paulo: Blucher. |
| e-book | Costa, G. G. de O. (2012). Curso de Estatística inferencial e probabilidades: teoria e prática. Rio de Janeiro: Atlas. |
| acervo | Dancey, C. P., & Reidy, J. (2019). Estatística sem matemática para psicologia (7ª ed.). Porto Alegre: Penso. |
🌐 Referências · Recursos na Web
| web (PT) | Estatística Fácil. O que é: Índice de Correlação de Pearson. Definição, fórmula e limitações do coeficiente. |
| web (PT) | Psicometria Online. Correlação de Pearson: o que é e como interpretar?. Interpretação de r e do coeficiente de determinação. |
| web (PT) | Peixoto, Introdução à Ciência de Dados: Correlação. Scatter plots, interpretação de r, Pearson vs relações não lineares, pearsonr(). |
| web (PT) | Matos, Estatística + R: Correlação entre variáveis. Gráficos de dispersão, matriz de correlação, quando usar Pearson e Spearman. |
| web (EN) | OpenStax, Introductory Statistics 2e: cap. 12.2 e 12.3. Scatter plots e coeficiente de correlação, gratuito, com exemplos educacionais. |
| web (EN) | Khan Academy: Correlation coefficient review. Interpretação visual de r e exercícios de associação gráfico × coeficiente. |
| documentação | SciPy. scipy.stats.pearsonr. Documentação oficial usada nos exemplos em Python. |
| simulador | R Psychologist: Understanding Correlations. Ajuste r com slider, arraste pontos e observe o efeito de outliers na nuvem. |
| simulador | Art of Stat: Scatterplots & Correlation. Mova ou remova pontos, sobreponha reta de tendência e teste a robustez de r. |
| simulador | Art of Stat: Guess the Correlation. Treine estimar r a partir de scatter plots gerados aleatoriamente. |

CC BY 4.0 DEED